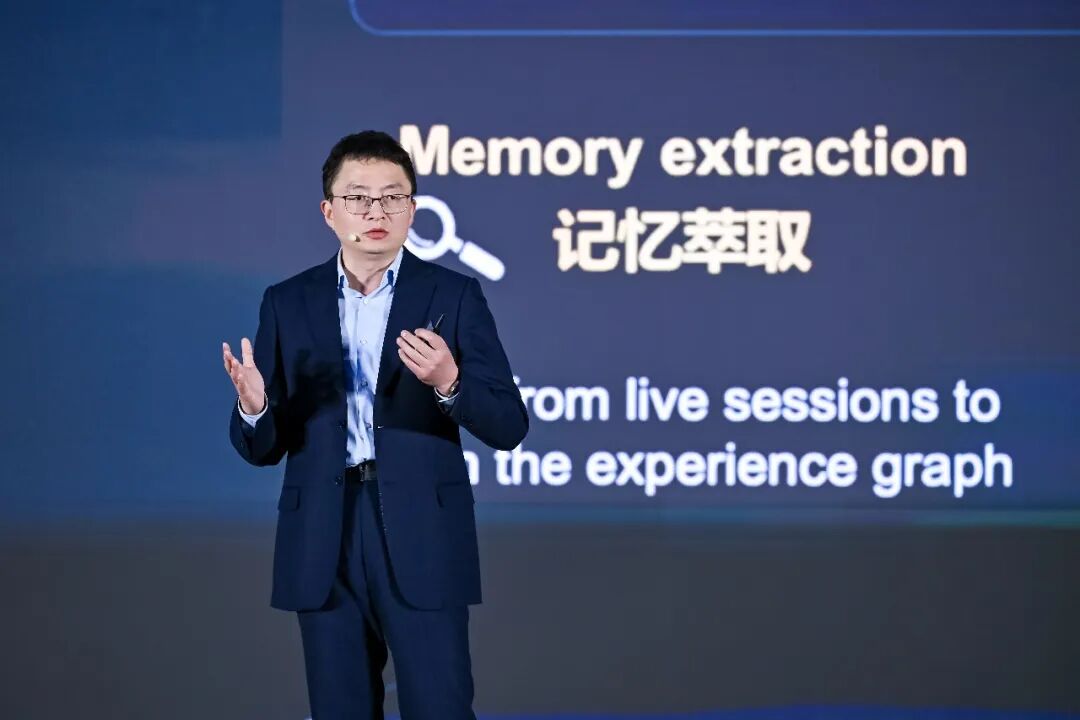
9 月 17 日,在华为全联接大会 2026「华为数据存储峰会」上,华为公司副总裁、数据存储产品线总裁袁远发表主题演讲。
9 月 17 日,在华为全联接大会 2026「华为数据存储峰会」上,华为公司副总裁、数据存储产品线总裁袁远发表主题演讲。他表示,华为 AI 数据平台解决方案已在金融、医疗等行业中助力智能体应用进入生产环节,完成落地验证。未来,该方案将围绕推理体验、效率和韧性维度,全面升级能力,助力广大客户解锁更多新价值场景,加速 AI 规模化应用落地。

华为公司副总裁、数据存储产品线总裁袁远
当前,AI 已跨越算力、模型、智能体平台三个时期,进入以数据决胜的关键阶段。数据规模和质量直接决定 AI 发展速度与能力上限,私域专业知识库可降低模型幻觉、提升推理精确度,海量上下文数据和经验记忆能有效辅助智能体作出精准决策。
袁远表示,华为发布的业界首个「3+1」AI 数据平台解决方案,基于 OceanStor AI 语义存储,通过集成知识库、KV Cache 库与记忆库,依托 UCM(Unified Cache Manager)技术,已在 AI 辅助诊疗、AI 编程(AI Coding)等 20 余个关键业务场景中,提升推理效率与精确性,取得显著成果。
AI 辅助诊疗:构建高精度知识库,助力临床级智能体应用落地
长期以来,传统医疗服务高度依赖专家经验,通用模型难以理解医疗专业知识,导致智慧医疗难以落地。国内某三甲医院采用华为 AI 数据平台,构建临床级辅助诊疗智能体,将海量医学文献、疾病编码与患者病史等原始数据,转化为向量化、高精度的医疗知识库,辅助医生诊断生成报告。AI 辅助诊断报告的采纳率从 50% 提升至 90%,智能体每日调用次数从 2000 提升至 16000,大幅提高医生工作效率。
AI 编程:以「以查代算」技术路径,实现 3 倍 Token 生成效率
在 AI 编程中,主流的 SDD(Specification-Driven Development)开发模式涉及多轮交互、长序列推理与长周期运行任务,KV Cache 数据成倍增长,对底层计算资源和存储系统带来更大的挑战。国内某企业基于华为 AI 数据平台的 KV Cache 库和 UCM 技术,通过自适应多级缓存统一调度 KV Cache 数据,并以前缀缓存(Prefix Cache)与智能后缀联想等核心能力,实现用「关联查找」代替「重复计算」,将 AI 编程应用的首 Token 时延(TTFT)降低 80%,降至 10 秒以内,Token 吞吐率(TPS)提升 2.2 倍。
袁远表示,随着智能体加速融入更多行业,面向未来,华为 AI 数据平台解决方案将从推理体验、效率和韧性维度,全面强化能力,解决更多切实 AI 应用瓶颈。对此,华为提出三大技术创新方向:
• 创新一:通过构建数据本体定义知识间关系,将智能体任务正确率提升至 90% 以上。数据本体是知识之间的语义枢纽。未来的 AI 数据平台需在知识库上,构建数据本体模型,自动化动态识别、增强和层次化管理海量知识间的关联信息,让智能体真正「读懂」、精准检索知识,以获得更可靠的推理结果。
• 创新二:原生 KV 语义直通,单框提供 TB 级存储带宽。AI 推理场景下,主流 MOE 模型参数规模已达万亿级,KV Cache 数量膨胀,让单卡存储容量需求从 TB 级迈向数十 TB 级。未来的 AI 数据平台需支持原生 KV 语义和参数面直通网络,免除多层协议转换,将存储 I/O 时延从 350 微秒降至 55 微秒,KV Cache 加载速度提升 2 倍。
• 创新三:打造领先的智能体数据韧性能力,以意图识别引擎,实现秒级风险拦截、分钟级数据一致性恢复。AI 时代数据风险问题日益加剧。未来的 AI 数据平台需集成主动防护能力:一方面,通过异常行为检测技术,实时分析智能体意图和行为,预测与提前拦截 99% 的高风险操作;另一方面,内置 AI 勒索检测技术,实现 99% 勒索软件检测率。
最后,袁远表示,AI 的下半程在于数据。华为将提供创新力更强、覆盖面更广、技术底蕴更深厚的 AI 数据平台,适配更多复杂业务场景的 AI 应用需求:让未来银行 AI 数字员工能帮助客户进行可信决策,全方位守护数据资产安全;让更多城市可视化、动态实时检测特征指标,智能处理关键事件,步入智慧治理新阶段;让软件工厂能以更优的 Token 生成效能执行软件任务,实现高价值转换。华为愿携手千行百业客户与伙伴,共建坚实的存储底座,加速实现 AI 行业化落地。
来源:互联网