前沿模型参数量快速增长,超节点通过 Scale-Up 互连将多颗 AI 芯片组织成紧密协同的计算系统,成为支撑大模型运行的重要算力底座。但芯片数量的增加,并不意味着系统性能的同步提升。大模型运行过程中,超节点内不同芯片间需要频繁交换中间计算结果、访问彼此的内存资源,互连通信的高时延已成为超节点性能提升的瓶颈。
前沿模型参数量快速增长,超节点通过 Scale-Up 互连将多颗 AI 芯片组织成紧密协同的计算系统,成为支撑大模型运行的重要算力底座。但芯片数量的增加,并不意味着系统性能的同步提升。大模型运行过程中,超节点内不同芯片间需要频繁交换中间计算结果、访问彼此的内存资源,互连通信的高时延已成为超节点性能提升的瓶颈。
为破解超节点跨主机域数据移动的效率瓶颈,浪潮信息提出 Co-Fabric 融脉架构,通过四层精简协议栈、端口 ID 跨域路由与全局统一地址空间,打破主机域边界、实现 xPU 总线式互连,并同步在 arXiv 发布技术论文《Co-Fabric: Breaking Host-Domain Boundaries for Unified xPU Interconnection》。Co-Fabric 融脉架构将总线式的低时延、原生内存语义通信能力与网络式跨域扩展能力进行高效整合,实现总线能力从单主机节点扩展到整个超节点,让 xPU 之间在一个统一地址空间发起直接地址访问,大幅提升多元 xPU 之间的数据传输效率,相比传统总线式互连和网络式互连方案,通信性能大幅提升,为超节点在大模型应用中性能提升提供全新的互连技术路径。
统一寻址和原生内存语义,超节点构建高效计算域的关键
为了在扩大模型容量的同时控制计算成本,越来越多的大模型采用 MoE(混合专家)架构,通过路由机制选择少数专家参与每个 Token 的计算。但当不同专家分布在不同芯片上,Token 数据需要在芯片之间传输,计算结果也需要回传,由此产生大量 All-to-All 通信。据某大模型厂商实测数据显示,其大模型在推理过程中,约 47% 的前向计算时间消耗在芯片间的通信上。随着模型规模扩大,多芯片协同带来的通信开销问题日益突出,互连效率成为影响超节点性能提升的关键因素。
提升超节点 Scale-Up 效率,不仅需要更高的互连带宽,还需要让跨主机域的 xPU 能够高效访问彼此的显存。要实现这一目标的关键是建立统一的地址空间,并支持原生内存语义,使 xPU 能够以直接内存访问的方式访问远端显存,减少额外的地址转换与数据搬运开销。同时,互连架构还需要解决跨域设备识别、硬件路由与可靠传输等问题,才能在降低通信时延的同时,支撑更大规模的 xPU 高效协同。
传统互连方案的挑战:总线类跨域受限,网络类通信时延高
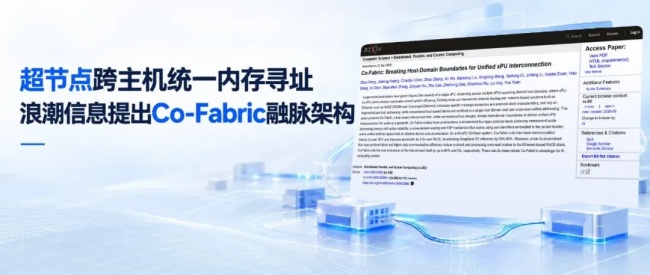
当前,多芯片互连通信主要有两类技术实现路径:一类以专用总线为基础,追求设备间直接访问和低时延;另一类采用以太网等网络技术,侧重跨主机连接与规模扩展。两类方案各有优势,但在跨主机域扩展时,仍需要解决低时延访问、统一寻址和可靠传输如何兼顾的问题。
> 总线类方案:专用互连域内高效访问,但跨域能力受到架构设计约束
总线类方案(bus-based camp),以 NVLink 为代表。这类互连架构把 xPU 互连视为一条扩展计算域的总线,通过构建一个专用的计算总线域,其中每个设备都直接参与数据交换,从而带来高路由效率、低时延和原生内存语义。然而,NVLink 面向的是一个以 xPU 南向接口为中心的互连域,xPU 数据交换局限在南向接口,而在北向没有解决多主机跨域内存一致性访问问题,需要通过 Scale-Out 网络,数据传输经过总线-网络-总线的协议翻译,通信开销大。
> 网络类方案:具备跨主机连接能力,但通信路径与访问管理仍需优化
网络类方案(network-based camp),使用 RoCE 等协议构建基于网络的互连。RoCE 具备内核旁路、零拷贝数据传输与硬件卸载传输等优势,总体上降低了 CPU 开销并改善了时延,但本质上仍是一种基于网络的架构。因此其通信模型依赖消息语义——远端内存访问需要显式注册内存区域、交换远端密钥、管理队列对。数据路径要穿越多层网络协议栈,并且每台主机各自维护独立的地址空间,没有原生的跨域统一寻址,通信时延较高,还会存在网络通信传输中常见的数据丢包问题,影响链路稳定性。这些架构缺陷会导致其数据搬运效率远不及基于总线的方案。
可以看到,总线类方案在专用互连域内具备低时延和直接访问的天然优势,但要将这种能力扩展到跨主机域的 xPU 协同,还面临跨域多主机设备访问难以统一寻址的问题,且难以直接实现原生的跨主机内存访问;网络类方案扩展时数据路径要穿越多层网络协议栈,会产生更高的时延,并影响传输稳定性。目前业界现有方案仍难以同时兼顾"跨域统一寻址、原生内存语义、跨主机域的硬件级低时延路由"。
Co-Fabric 融脉:跨越主机域边界,构建统一寻址的 xPU 互连体系
面对超节点规模扩展带来的互连挑战,浪潮信息基于融合架构的设计理念,创新推出 Co-Fabric 架构。不同于传统总线互连主要面向单机内部的设备连接,也不同于传统网络以报文传输为核心的通信方式,Co-Fabric 设计的核心,是将总线式直接访问能力延伸至跨主机域,通过统一寻址与原生内存语义,实现更大规模 xPU 之间的高效互连。
为此,Co-Fabric 架构融合系统架构、互连协议、底层软件、通信库等软硬件协同技术,设计了精简通信路径,减少软件介入,并通过 Port-ID 硬件路由提升跨域转发效率,同时以全局统一寻址支持远端 xPU 内存直接访问,以实现超节点低时延、高可靠的高效互连。
精简四层协议栈,兼顾低时延、高可靠性
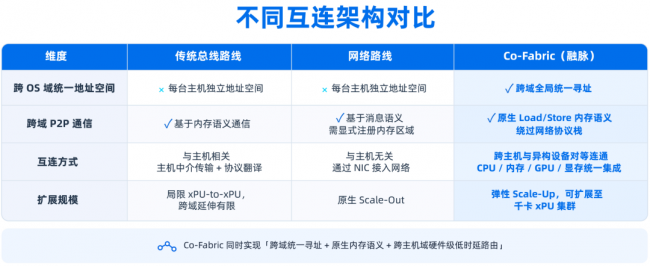
传统通用广域网协议栈采用 4~7 层(例如七层的 OSI 模型,包含物理层、数据链路层、网络层、传输层、会话层、表示层和应用层),在每一层封装处理都会增加时延,也影响数据传输的可靠性。针对这一问题,Co-Fabric 重新设计互连协议栈,将其精简为媒介层、链路层、Fabric 层和语义层,通过精简的协议层级、简化的通信语义和紧凑的处理流水线,减少跨域通信中的协议开销与软件介入,并结合流量控制和差错重传机制,兼顾低时延与高可靠性。
• 更少的传输层级:Co-Fabric 将协议栈精简为媒介层、链路层、Fabric 层和语义层,减少不必要的协议处理与封装开销,缩短跨域通信路径。
• 简化的内存语义:Co-Fabri 语义层采用 Load/Store 直接访问远端 xPU 显存,减少对传统消息传递机制的依赖,降低软件处理开销。
• 紧凑的处理流水线:数据沿语义层、Fabric 层、链路层和媒介层依次处理,减少软件介入与中间缓冲,保证了传输的低时延,同时链路层结合信用流控和 ACK/NAK 选择性重传,降低缓冲区溢出风险,提升传输可靠性。
Port-ID 硬件路由,让总线式互连能力跨域延伸
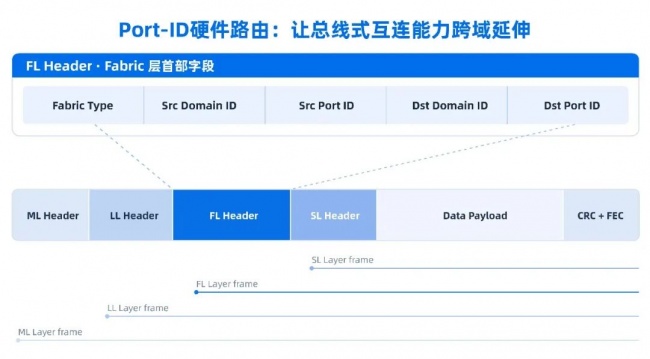
针对总线方案跨域延伸受限问题,Co-Fabric 将全局唯一的 Port-ID 编码在报文头部,由交换机解析 Fabric 层信息并完成硬件路由,无需 CPU 逐包参与转发决策。同时,该机制支持点对点单播、组播、广播及网内计算等多种加速传输方式。其创新价值在于,将跨域数据转发的关键决策交由硬件完成,减少主机处理环节对通信效率的影响,同时转发表随端口数线性扩展,可弹性扩容至千卡及更大规模,为更多 xPU 接入同一互连系统提供统一寻址的转发基础,构建百纳秒级低时延的内存语义互连域。
影子设备全局统一寻址,让远端 xPU 纳入统一设备视图
总线式能力跨域延伸的另一道难题,是如何让设备被统一识别,并让应用以一致的方式访问远端内存。传统多主机系统通常各自维护独立的地址空间,跨主机访问需要额外的地址映射和通信管理。针对跨主机互连如何原生统一寻址的难题,Co-Fabric 引入影子设备机制,将远端主机域中的 xPU 映射为虚拟影子设备,并为设备分配全局互不重叠的地址区间,使不同主机能够获得一致的设备枚举与地址视图。在相应硬件、驱动和内存映射条件满足时,开发者可以沿用 CUDA 编程范式,通过本地 load/store 指令访问远端 xPU 内存,而不必在应用层显式处理设备所在的物理主机。由此,总线式互连的直接访问模式得以延伸至跨主机域,为构建更大规模的统一寻址空间提供支持。
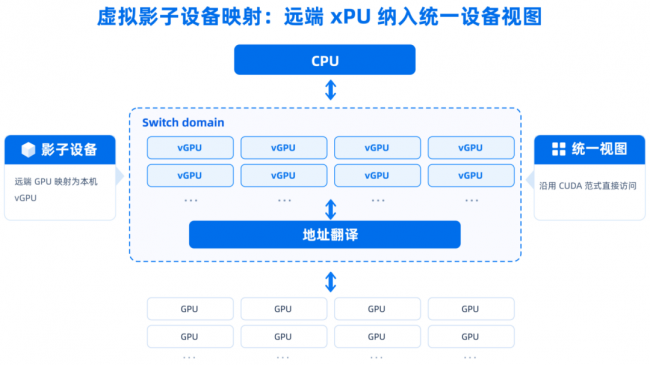
通过精简高效的协议栈、硬件路由与影子设备三项设计,Co-Fabric 分别从传输路径、转发机制和访问方式入手,尝试兼顾总线式互连的低时延优势与跨主机域的扩展能力。对于超节点而言,互连不再只是增加设备之间的连接带宽,还需要让更多计算资源能够高效协同,充分发挥整体系统的计算能力。
实测验证:Co-Fabric 融脉架构支撑超节点高效运行前沿模型
架构创新最终需要落到实际系统表现上。目前,Co-Fabric 已在元脑 SD200、元脑 SD200 Ultra 等超节点系统中完成验证。与同等配置的 RoCE 基线方案相比,Co-Fabric 互连方案的超节点运行 2.8 万亿参数规模的 Kimi K3 大模型,在通信时延、大模型推理性能、投入成本和功耗等方面均表现出明显优势。
大模型推理性能释放。Co-Fabric 通过全域统一寻址与原生内存语义,支持跨主机域 xPU 间直接显存访问,减少显存地址转换与 Buffer 中转带来的额外开销。测试数据显示,采用 Co-Fabric 架构的 SD200 Ultra 紧耦合 128 芯本土 AI 芯片,提供 8TB 统一编址显存和 64TB 内存,单机即可运行 2.8 万亿参数的 Kimi K3 大模型,AllReduce 通信时间降低 3.5 倍,Token 生成时延低至 5.85 毫秒,对应单用户 Token 生成速度约 170 tokens/s。
互连硬件投入与功耗同步优化。通过采用 Retimer 与 Co-Fabric 交换机替换相关以太网网卡及交换设备,元脑超节点服务器的互连整体 TCO 最高可降低 80%,互连功耗降低 5%。这为大规模互连系统在性能之外进一步优化建设与运行成本提供了空间。
随着大模型规模持续扩大,超节点的性能提升不仅取决于芯片数量和互连带宽,也取决于不同计算资源能否实现高效协同。元脑超节点互连架构 Co-Fabric 的核心创新,在于将总线原生内存语义与低时延访问能力延伸至跨主机域,并通过精简协议栈、Port-ID 硬件路由和影子设备全局寻址,构建统一的 xPU 互连体系。
该架构重构了大规模异构计算资源的组织与协同方式,为传统总线型互连突破主机域限制提供了新的实现方式,也为大规模超节点在性能、扩展性与成本之间寻求平衡提供了新的架构选择。
来源:互联网